Yandex SpeechKit: распознавание, синтез и проверка голосового процесса
Как выбрать режим SpeechKit, испытать речь на своих записях и связать результат с бизнес-процессом. API, стоимость, ошибки и сравнение с SaluteSpeech.
Представьте учебную запись: клиент сказал «не подтверждаю», а расшифровка потеряла отрицание. По числу правильно записанных слов результат может выглядеть неплохо, но действие по такому тексту будет ошибочным. Поэтому SpeechKit нужно испытывать на задачах, которые последуют за распознаванием.
Сначала определите результат: текст записи, голосовой ответ, поиск фрагментов или маршрутизация разговора. Это разные части системы. Распознавание речи само по себе не создаёт надёжного продавца и не подтверждает достоверность извлечённой суммы.
Что делает речевой слой
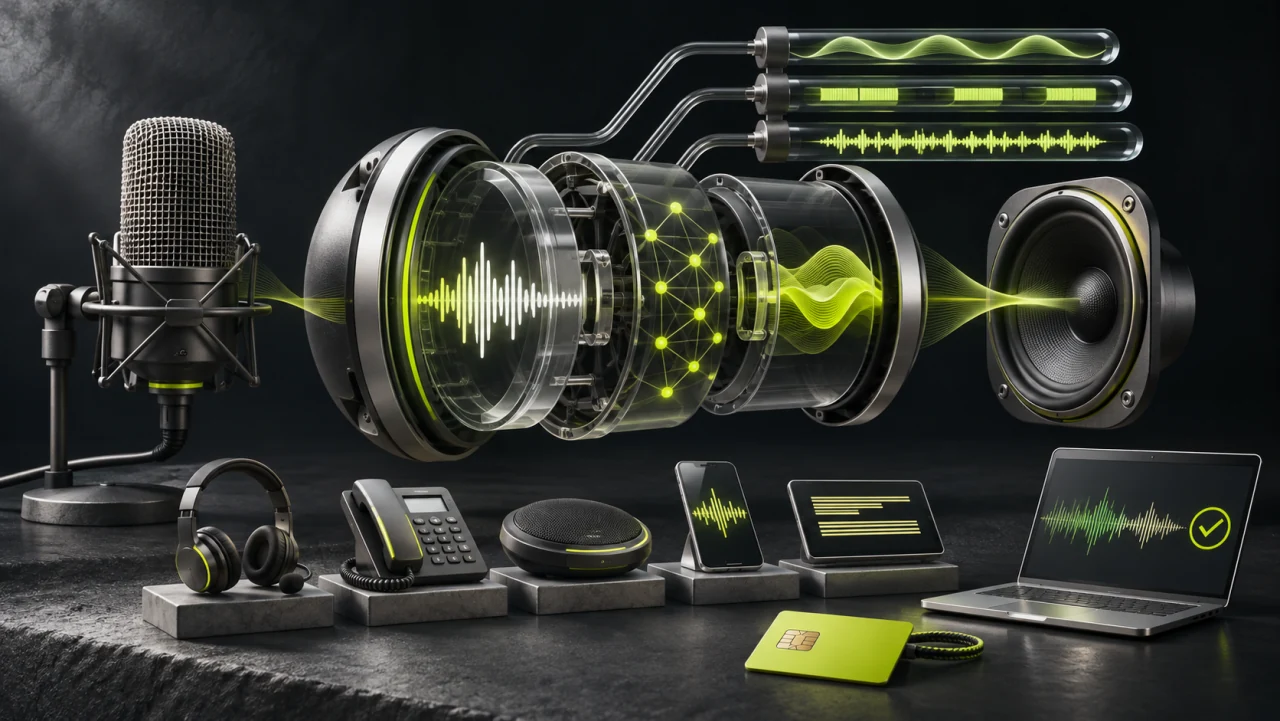
STT преобразует звук в текст. TTS озвучивает текст. Извлечение данных, оценка реплики и выбор следующего действия требуют отдельной логики и проверки возможностей выбранного продукта. Не стоит приписывать одному базовому вызову STT всю аналитику контакт-центра.
В документации синтеза SpeechKit описаны разные версии API, модели и настройки. Доступные голоса и способы управления произношением зависят от конкретного варианта. Для имени, адреса и артикула результат нужно прослушать, а не оценить по красиво написанному исходному тексту.
Пять практических сценариев
| Задача | Проверяемый результат | Контроль |
|---|---|---|
| Разбор звонков | Фрагменты для проверки качества | Сверка с аудио, без обвинений по ключевому слову |
| Голосовое меню | Правильное направление обращения | Подтверждение и возможность перейти к оператору |
| Протокол встречи | Черновик по расшифровке | Различение предложения и решения |
| Голосовой ввод | Заполненные поля запроса | Повтор существенных значений пользователю |
| Субтитры | Текст с согласованным временем | Редактура терминов, имён и переносов |
Слово «жалоба» может встретиться в фразе «жалоб нет». Для речевой аналитики нужен контекст. Выборочная ручная проверка должна включать и непомеченные разговоры, иначе пропущенные проблемы останутся невидимыми.
Выбор режима
Синхронный режим предназначен для небольшого предзаписанного аудио с установленными ограничениями. Для более длинных файлов проверяют асинхронный режим и его требования. Формат, число каналов и размер нельзя выбирать по списку возможностей другого API.
Для живой речи предусмотрено потоковое распознавание через gRPC v2 или v3. Документация рекомендует v3 для новых проектов. Результаты бывают промежуточными и окончательными; действие по незавершённой фразе может оказаться преждевременным.
Потоковая сессия имеет ограничения, поэтому для длинного разговора нужен предусмотренный порядок продолжения. Не обещайте нулевую задержку: её создают запись, сеть, распознавание, логика ответа и синтез. Проверять нужно весь путь до слышимого ответа.
Подключение без секретов в переписке
- Проверьте договорные условия, бюджет и допустимость тестовой записи.
- Выберите режим и официальный пример для его версии.
- Настройте отдельную сервисную учётную запись с нужными разрешениями.
- Сохраните ключ вне исходников, публичных журналов и клиентского интерфейса.
- После согласования выполните ограниченное испытание и проверьте расходы.
Для потокового STT в документации указана роль ai.speechkit-stt.user либо более широкое разрешение. Не выдавайте широкие права только ради удобства. Запрос собирают по актуальному примеру: тело и формат одного интерфейса нельзя механически переносить в другой.
Для готового приложения техническая часть может быть скрыта настройками поставщика, но проверка прав, обработки данных и ошибок остаётся. Установка интеграции не равна отсутствию технической ответственности.
Точность и предметная лексика
Составьте тест из разных дикторов, шумов, каналов и реальных терминов. Подготовьте ручную расшифровку. Отдельно учитывайте ошибки слов и ошибки значимых полей: номера заказа, даты, количества и отрицания. Один усреднённый процент скрывает разную цену промахов.
Расширение модели имеет разные механизмы и условия. Настройка предметной лексики не сводится к обещанию «добавим словарь и всё станет точно». До включения логирования или передачи аудио для улучшения модели проверьте, разрешена ли такая обработка.
Медицинская запись требует отдельного согласованного процесса и профильной проверки результата. Расшифровка не является диагнозом. Для любых чувствительных материалов оцените хранение, доступ, журналы и дальнейшие копии; российское размещение одного сервиса не доказывает допустимость всей цепочки.
При повторной обработке или уточнении окончательного текста не создавайте новое бизнес-событие автоматически. Один и тот же номер заказа может прийти в нескольких технических сообщениях. Приложение связывает их с исходной записью и отдельно подтверждает действие.
Сравнение и масштаб
SaluteSpeech также предлагает распознавание и синтез. Сравните оба решения на одном наборе с одинаковыми критериями, включая задержку, значимые поля, интеграцию и полную стоимость. Универсальное превосходство на диалектах или отраслевых терминах без такого теста утверждать нельзя.
На небольшом потоке может хватить обработки записей после разговора. При росте добавляются очередь, повторные попытки, контроль дублей и мониторинг. Большой объём сам по себе не делает голосового робота необходимым.
Стоимость и критерий продолжения
Тарификация SpeechKit зависит от режима и версии API. Для синтеза нельзя всегда считать только символы по одному правилу. Учитывайте округление, повторные запросы, хранение, телефонию, дальнейший анализ и ручную проверку.
Учебный объём: 120 звонков по четыре минуты дают 480 минут исходного аудио в день до особенностей тарификации. Если на обработку результатов требуется дополнительный сотрудник, его время входит в расчёт. Обнаруженная проблема не означает автоматически окупившийся месяц.
Пилот должен показать полезные принятые результаты и ошибки на всём пути. Для подготовки такого испытания можно обсудить голосовой процесс с АГЕНСТВОМ ИИ TRUE, без обещания фиксированной точности и срока возврата вложений.
Читайте также
ИИ-бот под задачу бизнеса: ответы, действия и передача сотруднику
Разрабатываем помощника по вашим данным и правилам. От первого обращения до подготовленной задачи для команды.
Открыть материал