Векторные представления текста: как устроен поиск по смыслу
Embeddings в поиске документов: подготовка данных, выбор модели, проверка качества и обновление индекса.
Текст превращают в числовое представление
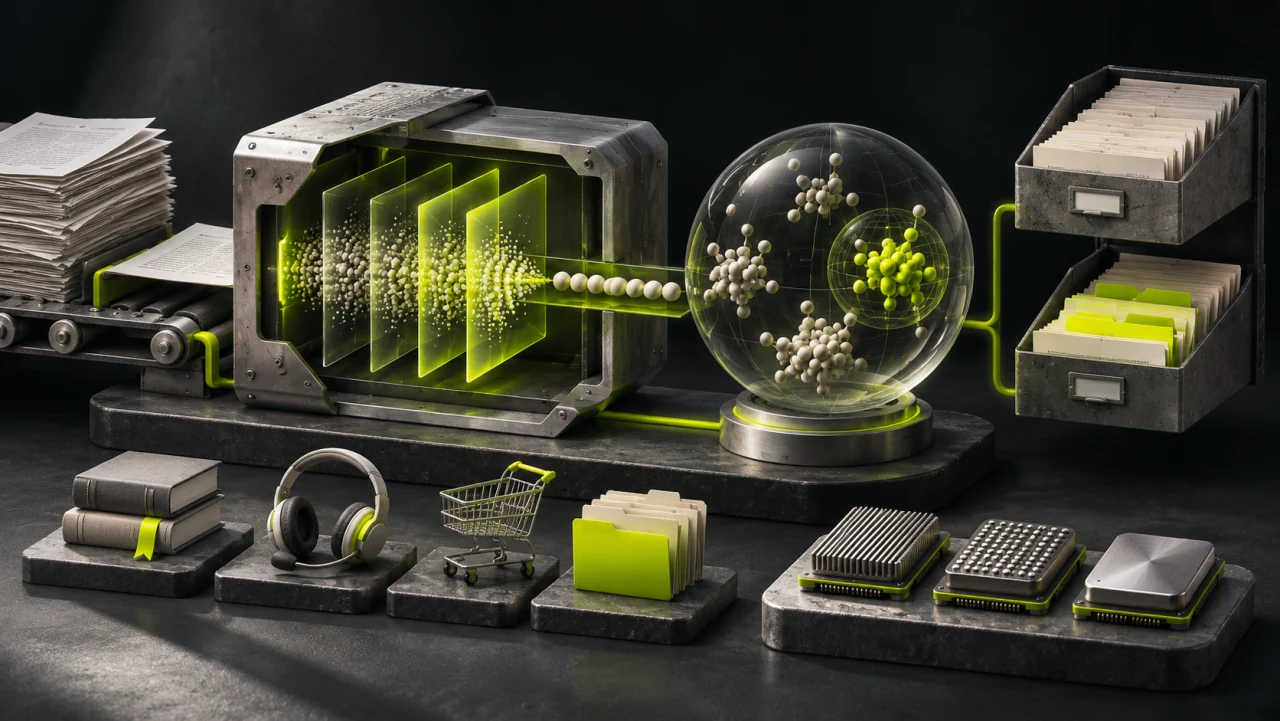
Embedding – набор чисел, который модель строит для текста. В задачах поиска такие представления сравнивают, чтобы находить близкие по смыслу фрагменты. Поиск может связать вопрос «когда вернут оплату» с разделом о сроках возврата денег, даже если слова различаются.
Это полезная возможность, но она не означает понимание любого документа. Модель может сближать похожие темы и пропускать решающее различие. Условия «возврат возможен» и «возврат невозможен» используют почти одинаковые слова, поэтому качество нужно проверять на таких случаях.
Где это применяют
Представления помогают искать по внутренним инструкциям, группировать обращения и находить похожие документы. В RAG-системе поиск сначала находит фрагменты, затем языковая модель составляет ответ по найденному. Сама коллекция чисел не пишет ответ и не проверяет его юридическую точность.
Для классификации запросов можно сравнивать их с описаниями известных категорий. Но порог похожести подбирают на размеченных примерах. Неизвестный запрос должен иметь возможность остаться без категории, иначе система уверенно отправит его не тому сотруднику.
Путь документа до выдачи
- Извлечь текст и проверить таблицы, заголовки и примечания.
- Разделить материал на смысловые фрагменты с достаточным контекстом.
- Сохранить источник, версию и права доступа.
- Построить представления выбранной моделью.
- Поместить их в индекс для поиска.
- Проверять запрос той же совместимой моделью и возвращать подходящие документы.
При замене модели нельзя просто оставить старые представления и строить новые запросы другим способом. Обычно требуется пересчитать индекс и повторить оценку поиска. Версию модели и параметры подготовки документов стоит хранить вместе с индексом.
Как выбирать инструмент
Облачный сервис упрощает запуск, но требует проверки передачи данных и условий хранения. Локальная модель даёт больше контроля над средой, при этом обслуживание и вычислительные расходы остаются вашей задачей. Бесплатные веса не делают эксплуатацию бесплатной.
Сравните несколько вариантов на одинаковых вопросах своей компании. Важны язык, длинные документы и профессиональные сокращения. Практическая реализация поиска описана в документации Sentence Transformers. Выбор модели по чужому рейтингу не заменяет такой проверки.
Поиск по смыслу и точные совпадения
Для артикула, номера договора или редкого названия точный поиск часто полезнее смыслового. Можно совместить подходы: сначала найти кандидатов разными способами, затем упорядочить их. Это требует проверки, но не заставляет выбирать один инструмент для всех типов запроса.
В учебной базе товаров создайте два почти одинаковых артикула. Вопрос о конкретной модели должен вернуть правильную карточку, даже если описание соседнего товара похоже. Добавьте опечатку и отдельный запрос без артикула, чтобы увидеть поведение системы.
Храните рядом с каждым фрагментом читаемый текст. Вектор без исходника не позволяет проверить, почему найден документ и что из него разрешено показывать. Для удаления записи нужен устойчивый идентификатор, иначе после обновления останутся дубли. Добавьте проверку поиска по старому и новому названию услуги. Иногда нужная информация существует, но в ней использовано внутреннее сокращение, незнакомое клиенту. Словарь соответствий или сочетание поиска по словам и смыслу может помочь больше, чем увеличение размера модели.
Проверка результата и обновления
Составьте набор вопросов с известными документами-ответами. Оценивайте, попал ли нужный фрагмент в выдачу, не потерялось ли исключение и не показан ли закрытый материал. Проверять только красивый итоговый ответ недостаточно.
При изменении документа обновляйте связанные фрагменты и удаляйте устаревшие версии из активного поиска. Иначе система будет находить противоречащие правила. Спроектировать базу знаний и проверку поиска можно через контакты агентства.
Читайте также
ИИ-бот под задачу бизнеса: ответы, действия и передача сотруднику
Разрабатываем помощника по вашим данным и правилам. От первого обращения до подготовленной задачи для команды.
Открыть материал
RAG: как ИИ отвечает по документам компании
Поиск по внутренним материалам, подготовка базы знаний и проверка ответов с опорой на источники.
Открыть материал
RAG для бизнеса: как отвечать по документам и проверять поиск
Что происходит между загрузкой базы и ответом модели, чем RAG отличается от дообучения и где возникают ошибки доступа и версий.
Открыть материал
LLM простыми словами: что умеет языковая модель
Как модель работает с текстом, чем отличается от базы знаний и где ей нужны проверяемые инструменты.
Открыть материал